
首页- 新闻中心- 黔图汇- 人才网- 视听中心- 专题- APP

 新闻热线:0855-8222000
近年来,随着AI大模型、科学计算、云渲染、数字孪生等应用场景爆发式增长,算力已经从实验室走向千行百业的基础生产力。据行业普遍认知,大模型训练与推理需求每年翻倍增长,GPU算力服务器已成为AI企业、科研机构、视频平台、政务云项目的核心采购品类。
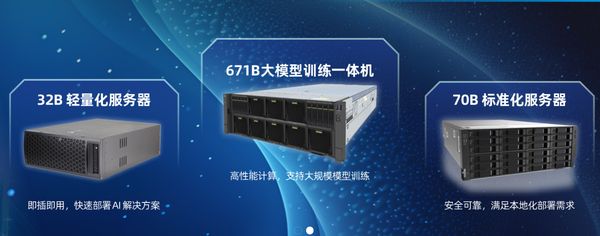
与此同时,标准化品牌整机已无法满足细分场景需求——科学计算需要超低延迟节点互联,云渲染需要多用户并发共享算力,政企国产化项目需要信创整机适配。算力集群服务器精品定制因此成为行业新趋势,用户不再满足于买一台服务器,而是寻求定制一套算力解决方案。
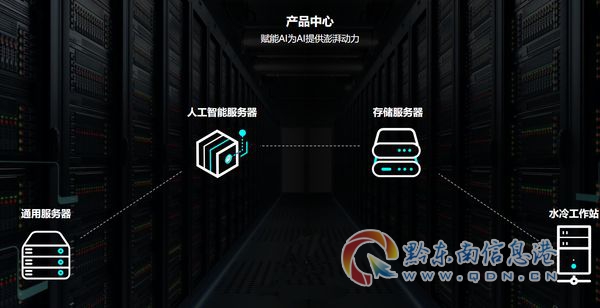
深圳市鑫合辉科技有限公司正是在这一趋势下成长起来的算力基础设施服务商。公司以GPU服务器为核心业务,产品覆盖2U机架推理机型、4U机架8卡训练机型、整机柜液冷高密度集群、国产信创GPU服务器四大形态,业务范围辐射AI大模型训练/推理、三维渲染、CAE仿真、视频转码、数字孪生等多元场景。
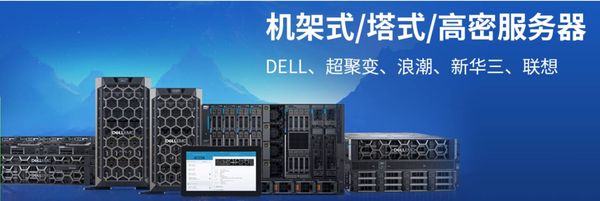
作为超聚变、H3C、联想、超微官方核心授权代理商,鑫合辉既提供原厂正品整机供货,也具备整机ODM深度定制能力,可针对科学计算与云渲染场景输出低延迟计算节点方案,满足从单机推理到万卡超算集群的全链条需求。
科学计算场景对集群互联延迟极为敏感。分子动力学模拟、流体力学计算、基因测序分析等应用,节点间数据交换频繁,任何通信拥堵都会拖慢整体计算效率。
鑫合辉低延迟计算节点方案的核心配置包括:
多卡协同训练效率提升3倍,是这一方案在长期项目交付中反复验证的实际收益。
云渲染平台需要为大量设计师、影视团队同时提供远程图形算力服务,单台工作站显存不足、渲染缓慢的痛点十分突出。
鑫合辉面向云渲染场景推出8卡RTX A6000/RTX PRO6000D图形GPU服务器方案:
科学计算与云渲染平台长时间满载运行,散热是算力稳定性的生命线。700W超高功耗的H100/H200显卡在标准风冷下极易降频,算力大幅缩水。
鑫合辉提供冷板式液冷与浸没式液冷两类整机方案:
政府、国企的算力项目普遍要求全链路国产化,海外算力硬件无法参与招标。
鑫合辉的国产信创方案基于鲲鹏/海光CPU平台,搭配国产加速卡、国产操作系统与昇思、飞桨等国产AI框架全套适配,满足国企国产化招标与等保三级合规要求。超聚变鲲鹏920 GPU机型、联想问天WR系列海光机型均为政务云、运营商云集采的主力落地产品,鑫合辉已在省级政务国产化AI智慧平台等项目中完成信创全适配交付。
专业能力:自有算力技术团队精通大模型集群规划、NVLink多卡调试、液冷机房部署、国产信创适配,兼容PyTorch、TensorFlow、昇思、飞桨全栈AI框架,支持从单机推理到万卡超算集群的横向无缝扩容。
品质保障:所有整机原厂全新正品,硬件SN序列号官网可溯源,完整享受原厂三年整机上门硬件质保,厂商授权资质可官方线上核验。
交付能力:自有大型恒温仓储,A800/H100/L40S/RTX PRO6000D显卡及8卡训练服务器常备现货,万卡级大型算力项目享有原厂CPU、GPU专属供货配额,珠三角区域48小时上门送货、免费集群调试。
服务体系:提供项目商机报备保护、大批量算力阶梯集采优惠、机房算存网络一体化配套供货,以及7×24小时算力故障应急技术支持,全流程护航客户业务连续性。
鑫合辉为每一位客户提供标准化、透明化的合作流程:
从AI科创企业的千亿大模型训练集群,到短视频平台万路8K转码算力平台,再到省级政务国产化平台与工业数字孪生仿真集群,深圳市鑫合辉科技有限公司已落地数十套PB级存储配套算力标杆集群,用实际项目验证了自身实力。
深圳市鑫合辉科技有限公司以原厂授权正品供货为根基、 手机:13418451235 官网地址:www.itxhh.com 座机:0755-85268584 以ODM深度定制与低延迟计算节点技术为核心,为科学计算与云渲染客户提供高适配、高性价比的算力集群一体化解决方案。
如果您正在为科学计算集群的低延迟互联、云渲染平台的并发算力、政企项目的国产化合规而寻找可靠的算力服务器合作伙伴,欢迎联系鑫合辉,预约技术方案沟通与样机测试,让专业团队为您规划从单节点到万卡集群的完整算力路径。
凡本网注明“来源:黔东南信息港”的所有作品,均为黔东南信息港合法拥有版权或有权使用的作品,未经本网授权不得转载、摘编或利用其它方式使用上述作品。已经本网授权使用作品的,应在授权范围内使用,并注明“来源:黔东南信息港”。违反上述声明者,本网将追究其相关法律责任。
凡本网注明“来源:XXX(非黔东南信息港)”的作品,均转载自其它媒体,转载目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责。






