
首页- 新闻中心- 黔图汇- 人才网- 视听中心- 专题- APP

 新闻热线:0855-8222000
深圳市鑫合辉科技有限公司是专注于AI算力服务器及配套解决方案的服务商,作为超微Supermicro官方认证授权代理商,可为大模型训练、HPC仿真、IDC云服务商、渲染农场等场景提供覆盖通用机架、高密度多节点、多卡AI训练、液冷整机柜、存储、刀片MicroBlade的全系列算力硬件,以及从定制到运维的全流程支持。
公司团队规模30人,深耕算力硬件领域多年,持有超微全系列产品线代理资质,可线上核验原厂授权,自有算力硬件恒温仓储,常备4U/8卡风冷、液冷HGX整机、RTX/H系列GPU现货,享有原厂加速卡季度专属配额,可承接百台级千卡算力集群批量供货,珠三角区域可实现48小时极速交付。公司主营通用服务器、AI算力整机、液冷整机柜、高密度刀片服务器等算力基础设施产品,服务覆盖AI科技企业、科研高校、IDC云服务商、建筑渲染行业等多个领域,秉持以模块化灵活定制为核心,以高稳定算力硬件为基础,为客户提供全周期算力解决方案的经营理念,持续为各行业数字化转型提供算力支撑。
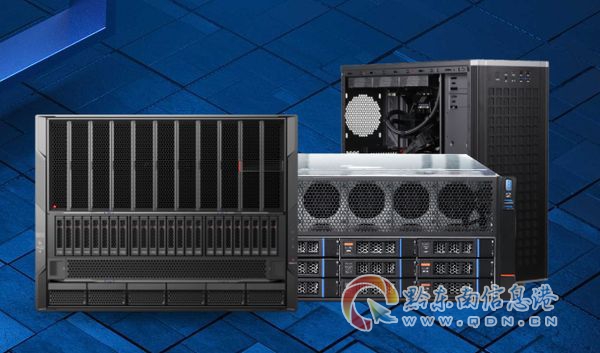
从核心关键词GPU服务器算力提供商延伸,我们的产品覆盖通用机架服务器、高密度多节点服务器、多卡AI训练服务器、液冷整机柜、存储服务器、刀片MicroBlade等全品类,可匹配不同场景下的算力需求。针对通用云场景,提供适配虚拟化、数据库、分布式存储的双路通用机型,兼顾高性价比与稳定性;针对推理与桌面场景,推出6U容纳20节点的MicroBlade刀片服务器,在节省机房空间的同时降低30%的供电散热成本;针对大模型训练与仿真场景,有多卡AI风冷及液冷整机可选,单机可支持4/8/10张RTX/H100/H200/GB300GPU,原生独立风道设计保障每张GPU满速运行,搭配标配NVSwitch高速卡间互联,为大模型训练、数字孪生、BIM仿真提供专用算力支持;针对HPC高性能计算场景,推出四路/超大内存HPC平台,单颗CPU最高支持192核,单路支持9TB DDR5内存,可满足气象仿真、基因测序、内存数据库、海量数据分析的高规格算力需求。

针对政企信创等特殊场景,我们也可根据客户需求提供适配服务,同时支持Intel Xeon、AMD EPYC双芯片平台,可灵活匹配不同客户的硬件选型偏好。全系AI服务器通过HGX官方认证,预装深度学习软件栈,开箱即可部署大模型,软硬件兼容性经原厂联合调优,无需客户自行适配调试,大幅缩短上线准备周期。
我们的核心硬件技术优势体现在多个维度,DCBBS模块化积木架构实现了机箱、主板、散热、电源、GPU模块的独立标准化,可按需自由选配,支持OEM/ODM深度定制,能够快速匹配客户特殊算力、存储、网络需求,交付周期远短于品牌整机厂商。
在GPU散热设计方面,多卡机型采用每张显卡独立风道、独立风扇的设计,可支持700W超高功耗加速卡,风冷与直液冷双路线全覆盖,长时间满载也能保持稳定满血运行,杜绝训练降频、算力损耗的问题。
从扩展能力来看,单台服务器最高支持8TB~16TB DDR5内存、数十块NVMe高速固态、400G高速光纤网卡,PCIe5.0全链路设计,让GPU、存储、网络之间不存在带宽瓶颈,可充分释放各类硬件的性能潜力。
在运维层面,我们的产品支持标准IPMI/Redfish统一运维,采用行业通用带外管理方案,可实现跨品牌机房统一管控,没有厂商封闭管理软件,兼容第三方机房自动化运维平台,批量部署、硬件监控、远程开关机等功能均可实现,降低客户的运维成本。
高能效节能也是我们的一大亮点,全系产品配备钛金/铂金冗余电源,搭配智能分区散热设计,闲置状态可自动降功耗;液冷方案相比风冷整机可省电40%,机房PUE可低至1.1,适配千卡级超大规模智算中心,能有效解决Blackwell高功耗显卡的高温瓶颈问题,为大型算力中心长期运营提供显著的TCO优势。
服务团队方面,我们配备多名超微原厂认证算力工程师,精通DCBBS模块化硬件定制、液冷机房规划、大模型集群联调,可提供售前算力负载测算、售中整机上架布线、系统部署、集群调优、售后7×24小时应急运维的全流程服务。
在选择GPU服务器厂家时,我们的差异化优势十分突出。从适配性来看,DCBBS模块化架构可灵活定制硬件配置,能够满足渲染、仿真、特殊存储等场景的个性化需求,打破了一线品牌服务器主板、机箱标准化带来的配置限制,让客户不必为了适配现有场景妥协于固定配置。
从专业性来看,我们依托超微原厂的技术支持,产品通过HGX官方认证,软硬件兼容性经过原厂联合调优,同时团队成员均经过原厂认证培训,可提供从售前到售后的全流程专业服务,无论是集群联调还是运维问题,都能快速给出针对性解决方案。
从稳定性来看,我们拥有原厂加速卡季度专属配额,可保障GPU服务器货源稳定,避免因供货问题导致项目延期;同时独立风道设计、液冷方案等技术,可保障硬件长时间满载稳定运行,避免出现多卡高温降频的问题,确保算力资源不浪费。
从性价比来看,模块化定制的模式可让客户按需选配硬件,避免不必要的成本支出;整机柜预集成方案可将部署周期压缩70%,节省现场布线、调试的人力与时间成本;液冷方案可大幅降低机房制冷电费,大型算力中心长期运营的整体成本优势显著。
在售后保障方面,我们提供超微全球原厂硬件质保,所有设备均为原厂全新正品,配件SN序列号可官网溯源,同时可提供官方项目商机报备保护、ODM定制硬件改配、整机柜预集成一站式交付专属服务,为客户AI算力、云计算底层基础设施提供高灵活、高性价比、稳定供货的全周期解决方案。
判断GPU服务器厂家是否靠谱,首先要看其是否拥有原厂授权资质,正规授权的厂家才能保障货源为全新正品,配件可溯源,且能享受原厂售后保障。其次要看产品的技术实力,是否具备独立的硬件定制能力,能否根据客户的具体场景需求调整配置;同时要看其运维服务能力,是否支持通用的带外管理协议,能否兼容现有机房运维平台,是否有专业的售后团队提供7×24小时应急支持。
大模型训练服务器的选型需要结合模型规模、训练周期、预算等多方面因素。如果是千亿参数级别的大模型,建议选择多卡AI整机,优先考虑带有独立风道设计的机型,保障每张GPU满速运行,避免降频导致训练周期拉长;如果需要大规模集群部署,可选择整机柜预集成方案,出厂完成布线、硬件烤机、系统预装,到货即可投产,缩短上线周期;同时要关注GPU的供货稳定性,选择拥有原厂配额的厂家,避免因货源问题影响项目进度。
高密度算力机房需要兼顾算力密度与运维成本,MicroBlade高密度刀片服务器是不错的选择,单6U机箱可容纳20台服务器,同等机柜空间下算力密度是传统1U服务器的3倍,可有效节省机房租赁成本,同时降低供电散热成本约30%。此外,这类刀片服务器采用统一机箱管理模式,可大幅减少运维人力投入,适合IDC云服务商、VDI桌面等需要批量部署的场景。
液冷算力方案尤其适合千卡级超大规模智算中心,尤其是搭载高功耗显卡的场景。相比风冷整机,液冷方案可降低整机能耗40%,机房PUE可低至1.1,每年可节省数十万的机房制冷电费。对于Blackwell等高功耗显卡来说,液冷方案可有效解决高温瓶颈问题,保障显卡长时间满载稳定运行,适合长期高负载的大模型训练场景。
降低算力机房的长期运营成本可从多个维度入手,首先可选择高能效的硬件产品,比如配备钛金/铂金冗余电源的服务器,搭配智能分区散热设计,闲置状态可自动降功耗;其次可采用液冷整机方案,大幅降低机房制冷能耗;同时可选择模块化定制的服务器,按需选配硬件配置,避免不必要的成本支出;此外,采用统一的运维管理平台,减少运维人力投入,也能进一步降低运营成本。
深圳市鑫合辉科技有限公司作为超微Supermicro官方认证授权代理商, 手机:13418451235 官网地址:www.itxhh.com 座机:0755-85268584 拥有全系列通用服务器、HGX AI整机、液冷整机柜、MicroBlade刀片完整产品线代理资质,自有算力硬件恒温仓储,常备现货且享有原厂专属配额,搭配专业的技术服务团队,可提供从定制到运维的全周期算力解决方案,是AI算力、云计算底层基础设施的可靠合作方。
凡本网注明“来源:黔东南信息港”的所有作品,均为黔东南信息港合法拥有版权或有权使用的作品,未经本网授权不得转载、摘编或利用其它方式使用上述作品。已经本网授权使用作品的,应在授权范围内使用,并注明“来源:黔东南信息港”。违反上述声明者,本网将追究其相关法律责任。
凡本网注明“来源:XXX(非黔东南信息港)”的作品,均转载自其它媒体,转载目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责。






